Мониторинг сервера 1С удобнее всего собрать на бесплатном стеке Grafana: Prometheus хранит метрики, экспортеры отдают показатели Windows, MS SQL и кластера 1С, Loki принимает строки технологического журнала, а Grafana показывает всё это на одном дашборде. Развёртывание занимает день-два, а дальше вы видите, что происходило с сервером в момент жалобы «всё зависло», а не гадаете постфактум.
Ниже — пошаговая схема для Windows: какие компоненты ставить, как оформить их службами, что прописать в конфигах и как завести технологический журнал. Подбор графиков под конкретную систему оставляю за рамками — это отдельная работа, но базовый каркас после этой инструкции будет работать.
Архитектура: что за что отвечает
| Компонент | Роль | Порт по умолчанию |
|---|---|---|
| Grafana | Дашборды, алерты, единое окно | 3000 |
| Prometheus | Сбор и хранение метрик (pull-модель) | 9090 |
| windows_exporter | Процессор, память, диски, сеть, службы Windows | 9182 |
| sql_exporter | Метрики MS SQL по SQL-запросам из конфига | 9399 |
| prometheus_1C_exporter | Сеансы, лицензии, регламентные задания кластера 1С | задаётся в его настройках |
| Loki | Хранилище логов | 3100 |
| Promtail / Grafana Alloy | Чтение файлов техжурнала и отправка в Loki | 9080 (Promtail) |
Prometheus сам ходит к экспортерам по HTTP и забирает метрики. Логи, наоборот, толкает агент: он читает файлы технологического журнала на сервере 1С и отправляет их в Loki. Grafana подключается к Prometheus и Loki как к источникам данных.
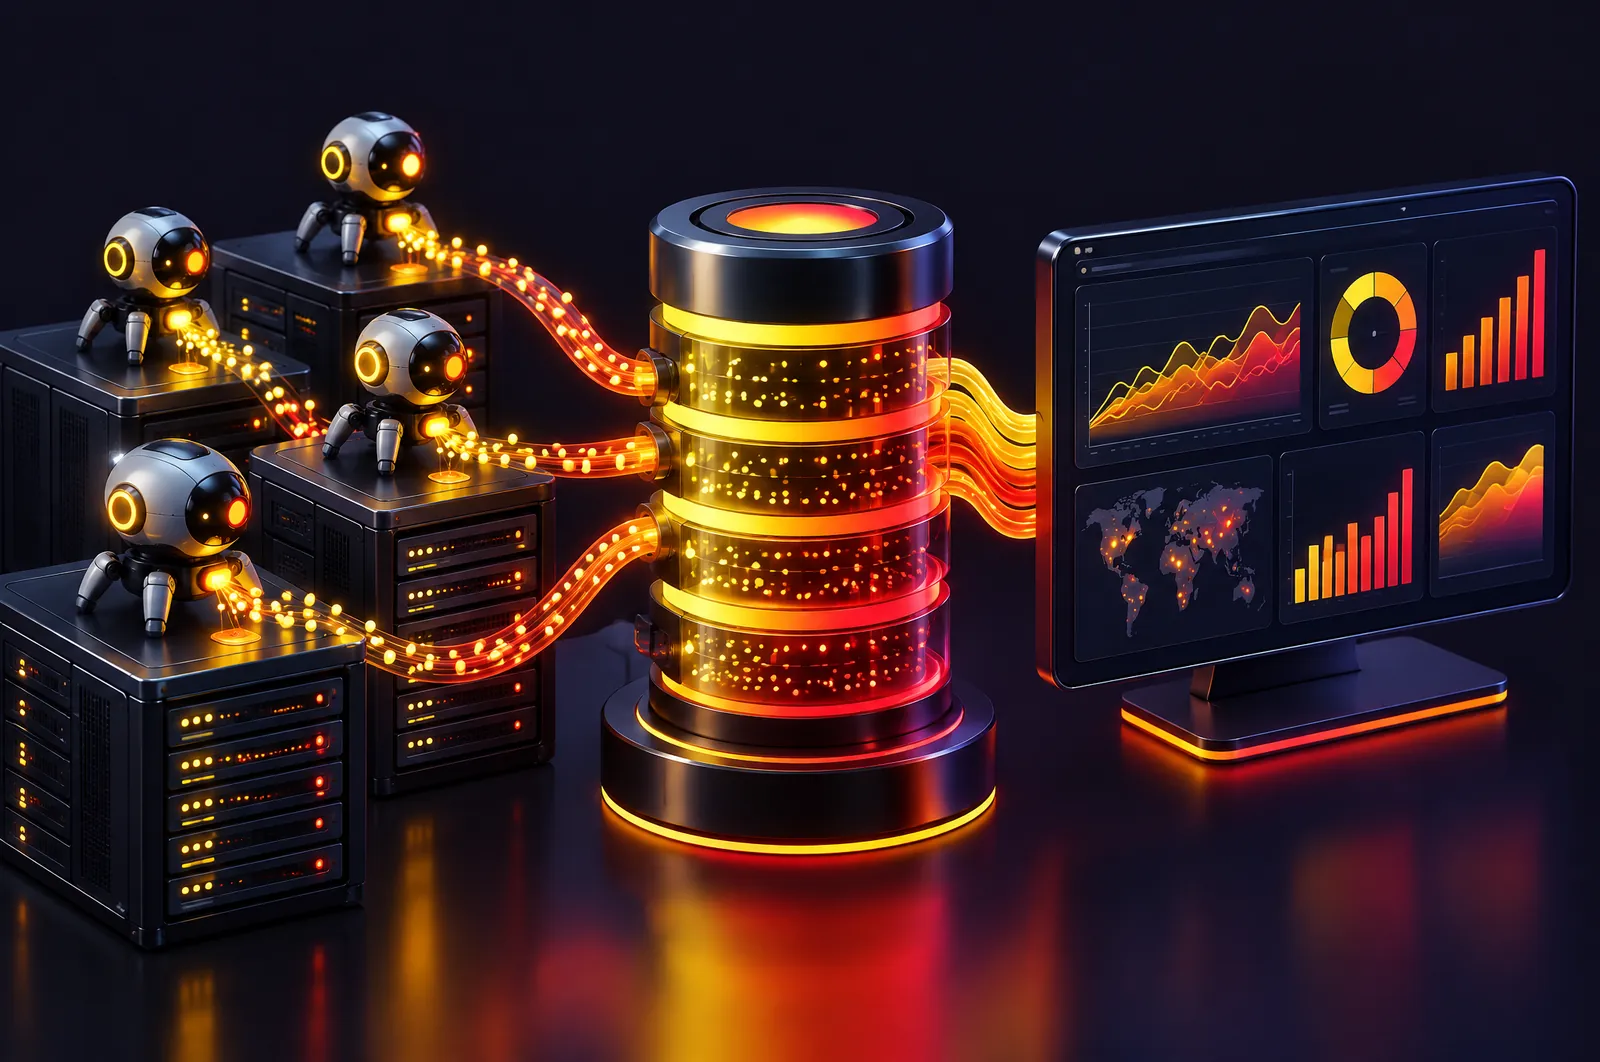
Мониторинг я обычно ставлю на отдельную машину или виртуалку, а на сервере 1С и сервере СУБД оставляю только экспортеры и агент логов. Так сама система наблюдения не отнимает ресурсы у рабочей базы и не падает вместе с ней.
Установка Grafana и Prometheus
Grafana ставится обычным установщиком с официального сайта и сразу регистрируется службой. После установки откройте http://localhost:3000, войдите под admin / admin и смените пароль — пропускать этот шаг на сервере, доступном из сети, не стоит.
Prometheus распространяется архивом. Распакуйте его, например, в C:\monitoring\prometheus. Рядом с prometheus.exe лежит prometheus.yml — основной конфиг. Сам по себе Prometheus службой не регистрируется, для этого понадобится NSSM.
Службы через NSSM
NSSM — утилита, которая превращает любой exe в службу Windows. Она есть в каталоге установки Grafana (внутри папки svc-<версия>), её можно скопировать в C:\monitoring. Команда nssm install <Имя> открывает окно с параметрами, но удобнее всё делать из командной строки под администратором:
nssm install Prometheus C:\monitoring\prometheus\prometheus.exe --config.file=prometheus.yml --storage.tsdb.retention.time=30d
nssm set Prometheus AppDirectory C:\monitoring\prometheus
nssm start Prometheus
AppDirectory — рабочий каталог службы, относительно него ищется prometheus.yml. Параметр --storage.tsdb.retention.time ограничивает глубину хранения метрик: без него диск со временем заполнится. После запуска проверьте http://localhost:9090 — должна открыться веб-консоль Prometheus.
Тем же способом ставятся все остальные компоненты: exe-файл, рядом конфиг, служба через NSSM с указанием файла конфигурации в аргументах.
Экспортеры для ОС, MS SQL и кластера 1С
На сервер 1С и сервер СУБД ставим экспортеры:
- windows_exporter — базовые метрики Windows: загрузка процессора, свободная память, очередь и задержки дисков, сеть, состояние служб. Для сервера 1С особенно полезны задержки дисков и состояние службы агента сервера.
- sql_exporter — универсальный экспортер для СУБД, в том числе MS SQL. Метрики описываются SQL-запросами в его конфигурации: число подключений, ожидания, размер журнала транзакций, использование памяти. Для PostgreSQL обычно берут отдельный postgres_exporter.
- prometheus_1C_exporter — экспортер с открытым кодом от сообщества, работает с кластером 1С через утилиты администрирования. Отдаёт количество сеансов, занятые лицензии, состояние регламентных заданий и другие показатели кластера.
После запуска экспортеров добавляем их в prometheus.yml:
global:
  scrape_interval: 15s

scrape_configs:
  - job_name: "prometheus"
    static_configs:
      - targets: ["localhost:9090"]

  - job_name: "windows"
    static_configs:
      - targets: ["srv1c:9182", "srvsql:9182"]

  - job_name: "mssql"
    static_configs:
      - targets: ["srvsql:9399"]

  - job_name: "1c_cluster"
    static_configs:
      - targets: ["srv1c:<порт экспортера>"]
Перезапустите службу Prometheus и откройте страницу Status → Targets: все цели должны быть в состоянии UP. Если цель в DOWN — чаще всего закрыт порт в брандмауэре Windows на стороне сервера.
Для всех трёх экспортеров есть готовые дашборды в каталоге Grafana и в репозиториях самих экспортеров. Я беру готовый дашборд как основу и убираю лишнее: на одном экране должны быть 8–12 графиков, по которым дежурный за минуту понимает, где проблема.
Технологический журнал 1С в Loki
Метрики показывают, что сервер перегружен. Технологический журнал объясняет, почему: какие запросы шли долго, где были ожидания на блокировках, какие исключения возникали.
Включаем запись журнала
Журнал настраивается файлом logcfg.xml в каталоге conf платформы на сервере 1С. Для постоянного мониторинга не пишите всё подряд — выберите события и порог длительности:
<?xml version="1.0" encoding="UTF-8"?>
<config xmlns="http://v8.1c.ru/v8/tech-log">
  <log location="D:\1C_TJ" history="24">
    <event>
      <eq property="name" value="EXCP"/>
    </event>
    <event>
      <eq property="name" value="TLOCK"/>
    </event>
    <event>
      <eq property="name" value="TTIMEOUT"/>
    </event>
    <event>
      <eq property="name" value="TDEADLOCK"/>
    </event>
    <event>
      <eq property="name" value="DBMSSQL"/>
      <ge property="duration" value="10000"/>
    </event>
    <property name="all"/>
  </log>
</config>
history — сколько часов хранить файлы на диске сервера. Порог длительности указывается в единицах журнала, которые зависят от версии платформы, поэтому значение подберите по документации к своей версии. Каждое событие начинается строкой вида мм:сс.микросекунды-длительность,ИМЯ,..., а одно событие может занимать несколько строк — это важно для сборщика.
Агент: Promtail или Alloy
Агент ставится на сервер 1С, рядом с файлами журнала: так не нужно открывать сетевой доступ к каталогу логов. Promtail переведён разработчиками в режим долгосрочной поддержки, его функции перешли в Grafana Alloy. На действующих установках Promtail ещё встречается, а для новых я ставлю Alloy. Ниже конфиг в формате Promtail — он нагляднее, и Alloy умеет перевести его в свой формат командой alloy convert --source-format=promtail.
server:
  http_listen_port: 9080
  grpc_listen_port: 0

positions:
  filename: C:/monitoring/promtail/positions.yaml

clients:
  - url: http://monitoring:3100/loki/api/v1/push

scrape_configs:
  - job_name: 1c_techlog
    static_configs:
      - targets: [localhost]
        labels:
          job: 1c_tj
          host: srv1c
          __path__: D:/1C_TJ/**/*.log
    pipeline_stages:
      - multiline:
          firstline: '^\d{2}:\d{2}\.\d{6}-'
          max_wait_time: 3s
      - regex:
          expression: '^\d{2}:\d{2}\.\d{6}-(?P<duration>\d+),(?P<event>\w+),'
      - labels:
          event:
Что здесь важно:
positions.filename— файл, где агент помнит, до какого места дочитан каждый лог. Каталог должен существовать, сам файл создастся.clients.url— адрес Loki с путём/loki/api/v1/push.__path__— маска файлов журнала. Платформа раскладывает журнал по подкаталогам процессов (rphost_1234,rmngr_5678), отсюда**.multilineсклеивает многострочное событие в одну запись по признаку начала строки.- В метку выносим только имя события. Длительность, пользователя, текст запроса метками делать нельзя: у Loki резко вырастет число потоков и он начнёт тормозить сам.
Запросы в Grafana
В Grafana добавьте источник данных Loki и откройте Explore. Пара примеров на LogQL:
# все управляемые блокировки, завершившиеся таймаутом
{job="1c_tj", event="TTIMEOUT"}

# количество исключений по 5-минутным интервалам
sum(count_over_time({job="1c_tj", event="EXCP"}[5m]))
Второй запрос можно положить на дашборд рядом с графиком загрузки процессора — сразу видно, совпадают ли всплески ошибок с нагрузкой.
Типичные ошибки
- Нет ограничения хранения. Prometheus и Loki без явного срока хранения постепенно съедают диск. Задайте retention сразу.
- Пишется весь технологический журнал. Полный журнал на рабочей базе за час набирает гигабайты и сам влияет на производительность. Только нужные события и порог длительности.
- Высокая кардинальность меток. Сеанс, пользователь или текст запроса в метках Loki — частая причина медленных запросов в Grafana.
- Цели в DOWN. Проверьте брандмауэр, адрес прослушивания экспортера и то, что служба реально запущена после перезагрузки.
- Мониторинг на том же сервере, что и 1С. На небольшой системе допустимо, но при проблемах с сервером вы теряете и данные о проблеме.
- Нет алертов. Дашборд, на который никто не смотрит, не спасёт. Хотя бы на свободное место на дисках, недоступность службы агента 1С и рост ожиданий на блокировках стоит настроить оповещения.
Что делать дальше
Когда каркас работает, его можно развивать: добавить оповещения в Telegram или почту, подключить счётчики производительности СУБД, собирать события CALL для поиска тяжёлых серверных вызовов. Если вы переводите систему на Linux, схема остаётся той же — меняются только способ установки служб и пути; подробнее про такую связку — в разделе 1С на Linux и PostgreSQL.
Если мониторинг нужен под конкретную проблему, а не «на будущее», его лучше разворачивать в рамках аудита производительности 1С: тогда набор метрик и событий журнала подбирается под гипотезы, а не наугад. Поддерживать стек в рабочем состоянии можно в рамках сопровождения 1С вместе с настройкой сервера 1С.
Итог
- Связка Prometheus + экспортеры + Loki + Grafana бесплатна и покрывает ОС, СУБД, кластер 1С и технологический журнал.
- На Windows компоненты удобно ставить службами через NSSM, указывая рабочий каталог и файл конфигурации.
- Агент логов ставится на сервер 1С; для новых установок берите Grafana Alloy вместо Promtail.
- В технологический журнал пишите только нужные события с порогом длительности, в метки Loki — только имя события.
- Сразу задайте срок хранения данных и базовые алерты, иначе мониторинг станет источником новых проблем.